来源:深蓝科技
DeepSeek又在全球AI圈上了热搜,它刚刚发布的最新大模型,又展现出自己超凡的低价成本优势。
就在周五深夜,DeepSeek官方发布的演示视频显示,一座可以自由切换视角浏览的故宫 3D 模型,从规划、编码到调试,可以全由DeepSeek-V4.1-Flash-1017自己完成,而价格最多可以低至GPT-6的四十分之一。
01 小版本,但分数大涨
杭州深度求索人工智能基础技术研究有限公司(DeepSeek)给这次更新的定位是“小版本更新”,名字里的1017就是发布日期。
它的底座是 9 月 10 日发布的 V4.1-Flash。这是 DeepSeek 新架构家族里最小的一款模型,采用 MoE(混合专家)结构,总参数 552B,原生支持看图,上下文长度 100 万 Token。9 月发布时,DeepSeek 就宣称它在性能、速度和成本上全面超过了自家上一代旗舰 V4 Pro。
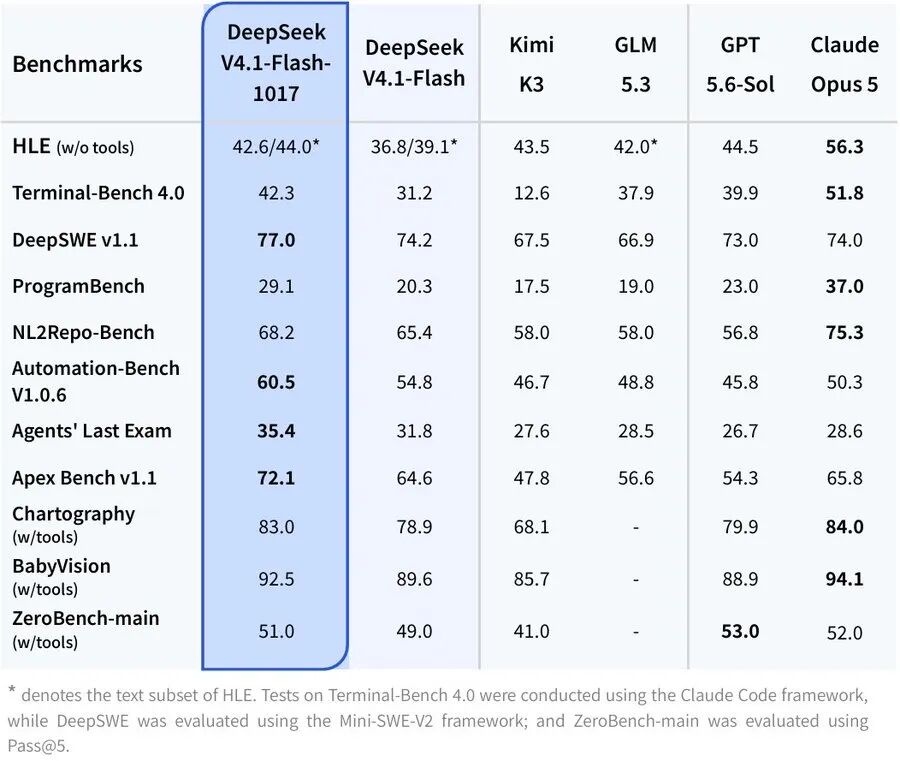
这次的 1017 版,在此基础上继续往上抬。除了亮点里的两项,从零搭建程序的 ProgramBench 从 20.3 分涨到 29.1 分,Agent 综合测试 Agents' Last Exam 从 31.8 分涨到 35.4 分。
官方把这称为"性能与成本的帕累托改进"。翻译成大白话就是:分数涨了,花费反而降了。
需要说明的是,这些成绩都由 DeepSeek 自己公布,测试框架也由它选定:Terminal-Bench 4.0 用的是 Claude Code 框架,DeepSWE 用的是 Mini-SWE-V2 框架。
02 赢的是上一代对手
DeepSeek在Hugging Face模型页上,把新版和Kimi K3、GLM-5.3、GPT-5.6 Sol、Claude Opus 5放在一张表里比。
对上Opus 5,它在DeepSWE(77.0比74.0)、Automation-Bench、Agents' Last Exam和Apex Bench上领先。但ProgramBench(29.1比37.0)和NL2Repo-Bench(68.2比75.3)还落后不少。
问题在于,表里的闭源对手都不是最新的。OpenAI在9月29日的DevDay上已经发布了GPT-6.1 Sol,定价输入每百万Token 2美元、输出10美元;Anthropic现在的旗舰是Opus 5.5。这两个都没进对比表。
所以更准确的说法是,它赢了上一代,还没跟这一代正面过招。
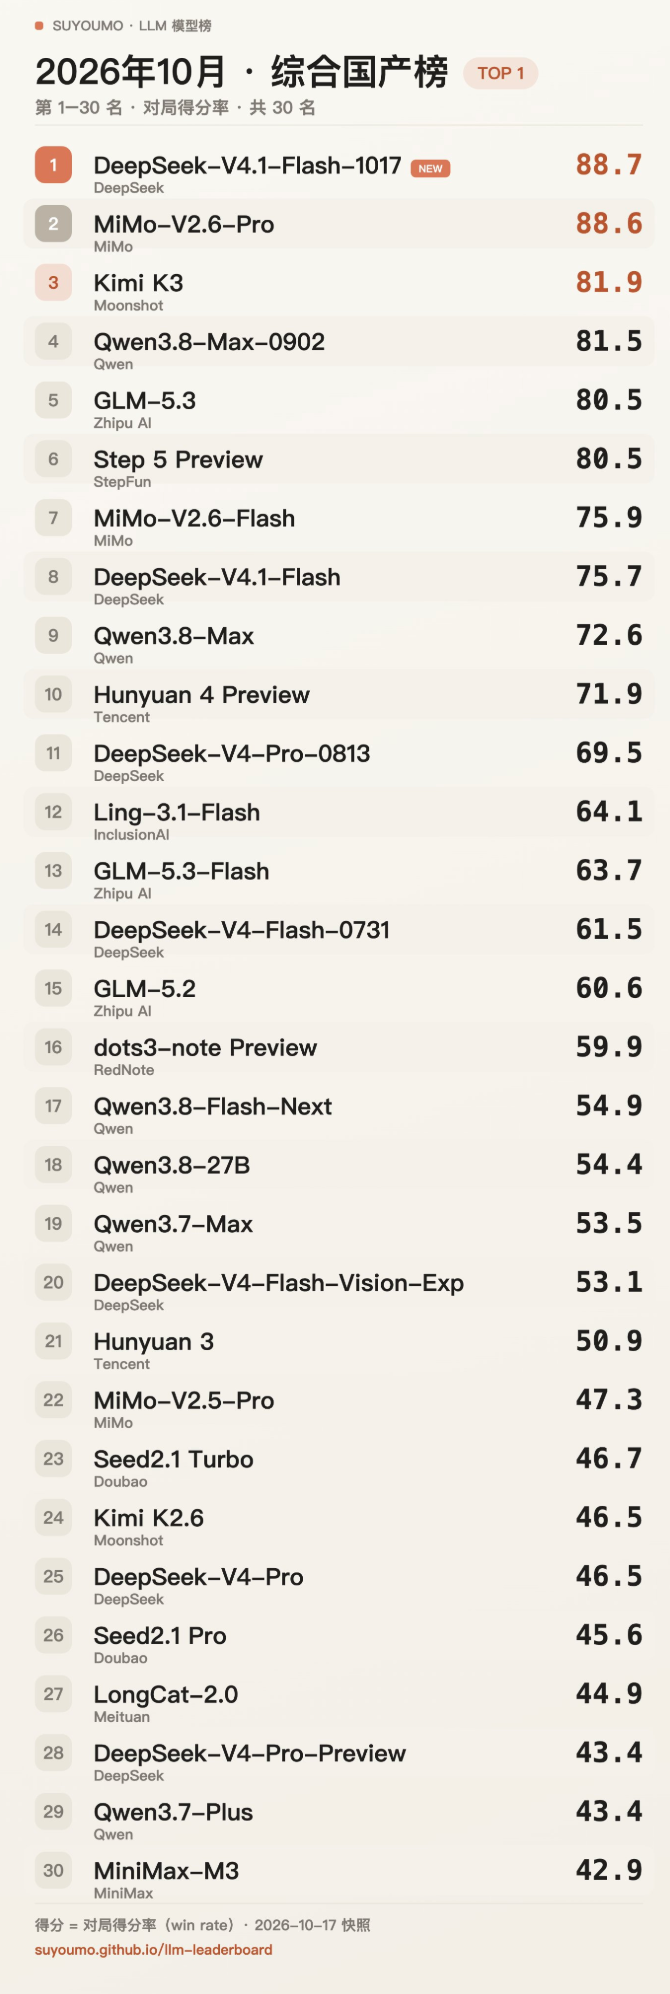
第三方榜单倒是很快有了反应。SUYOUMO的LLM模型榜10月17日快照显示,DeepSeek-V4.1-Flash-1017以88.7的对局得分率(win rate)冲到“综合国产榜”第一,只比小米MiMo-V2.6-Pro的88.6高0.1分,Kimi K3以81.9排第三。
03 “许愿式编程”
DeepSeek给这次的新能力起了个名字,叫“许愿式编程”。用户把需求说清楚,规划、编码、运行、调试都交给模型。
官方介绍,新版用带自我反馈的强化学习,专门练了从零做完一整个项目的能力。演示里除了故宫,还有一个网页赛车游戏和一个《传送门2》的复刻。
比演示更值得看的是一个细节。这次更新专门针对自家的DeepSeek Harness,以及腾讯旗下的CodeBuddy、WorkBuddy做了优化,Harness还同步出了0.2.1适配版。
可见DeepSeek很清楚自己的模型会被用在哪儿。它瞄准的是Agent工具链里的开发者,聊天框和评测榜单都排在后面。
04 搜索开始单独收钱
模型之外,同天开放的搜索API,可能意味着更长远的打算。
DeepSeek这次把自研搜索引擎拆成两个接口:Search负责搜网页,Fetch负责抓取网页内容。每个接口每1000次成功调用收0.75美元,国内5元,调用失败、返回空结果或超时都不收费。
按官方的说法,这套“AI原生”搜索引擎一直在给DeepSeek自家的联网功能供货,每天处理全球数亿次请求,索引了数千亿网页。它还会专门过滤SEO作弊、GEO操纵(专门写来影响AI推荐结果的内容)和低质量的AI生成内容。
过去,搜索是产品里顺带送的。现在单独拆出来定价,有点像运营商把通话、短信、流量分开卖。
DeepSeek也给了试用期。DeepSeek API用户在DeepSeek Harness、Claude Code和Codex里通过服务端工具调用搜索,到北京时间11月1日零点前都免费。之所以能在Claude Code和Codex里用,是因为DeepSeek的API同时兼容OpenAI和Anthropic两种接口格式,开发者可以直接把DeepSeek设成这些工具背后的模型。
一个便宜的编程模型,加上一层自家搜索,用同一个API密钥就能调用。这样一来,DeepSeek就和专做搜索API的公司抢起了同一批Agent开发者。我们的判断是,它正在从卖模型,转向给Agent铺管道。
05 单价太便宜
发布当天,X上有个说法传得很快:DeepSeek新模型追上了Opus 5,成本却低了97%。不少人说,又一个“DeepSeek时刻”来了。
评论区很快有人指出,97%说的是官方DeepSWE图表上的单任务成本,不是每Token的价格。按官方图表,新版max档77.0分,每个任务约0.2美元;前代74.2分,约0.5美元;GPT-6 Astra和Claude Opus 5落在每任务2美元到10美元以上。如果按Opus 5的10美元算,便宜了约98%,“97%”大体站得住,但这是DeepSeek自报的数据,也只对应DeepSWE这一项测试。
大模型的价格,至少要分三笔账来算。
第一笔是单价,也就是每百万Token多少钱。DeepSeek实行峰谷定价,闲时输入0.15美元、输出0.60美元,高峰时段是0.30美元和1.20美元。和GPT-6.1 Sol的2美元、10美元比,按高峰价算,输入便宜约6.7倍,输出便宜约8.3倍。
确实便宜,但单价上远没到97%。
第二笔是单任务成本,等于单价乘以Token用量。同一道题,不同模型想多久、调几次工具都不一样,Token消耗可能差出好几倍。单任务便宜97%,是单价低和用量少叠在一起的结果,而且只限于DeepSWE这一项测试、这一个框架。
第三笔是真实账单,变数最大。此前有国内作者实测上一版V4.1-Flash,跑了14组任务、烧掉3亿Token,发现它在复杂任务里喜欢多开子Agent,结果同样的计费标准下,总花费比更早的V4-Flash还高了36%。
单价低,账单不一定低。DeepSeek这次特别强调输出更短,针对的就是这个问题,实际效果还要等第三方来验证。
06 便宜的代价
就在新模型发布两天前,10月15日,DeepSeek服务出了故障,从北京时间8:11一直持续到13:04,前后4小时52分钟,对话服务和API都受了影响。官方随后道歉,按每个API用户10月8日至14日一周的消耗金额,以赠金形式全额补偿,并表示会“全面梳理并剥离单点依赖”。
有媒体统计,这已经是DeepSeek今年至少第18次较大规模的服务异常。
省下的钱里,有一部分是拿稳定性换的。账单上看不到这一项,但打算把生产系统交给DeepSeek的开发者,不能不算。
写在最后
从V4.1-Flash到1017版,DeepSeek的思路一直没变:不拼参数规模,让最小的模型去挑战旗舰,再把价格压到对手的零头。
模型能力越来越够用之后,大家比的就不只是谁更聪明,而是谁更便宜。在价格这件事上,DeepSeek已经交出了答卷。
可对开发者来说,光便宜还不够,还得稳。接下来有三件事值得盯:第三方对新版的独立测试结果,11月1日搜索API开始收费后的实际用量,以及DeepSeek能不能兑现“剥离单点依赖”的承诺。
