来源:硅基见闻
美西时间10月12日,Meta 超级智能实验室发布新一代大模型 Muse Wonder。这是 Meta 第一次正面宣称自己的模型挤进了“前沿”梯队,也就是和 OpenAI、Anthropic、Google 最强模型坐同一张桌子。
但看完 Meta 自己公布的成绩单会发现,它不是要在“综合智力”上赢下所有人,而是押注了另一条路:让 AI 记得住你、替你把事办完。
01 十四个月,从推倒重来到上桌
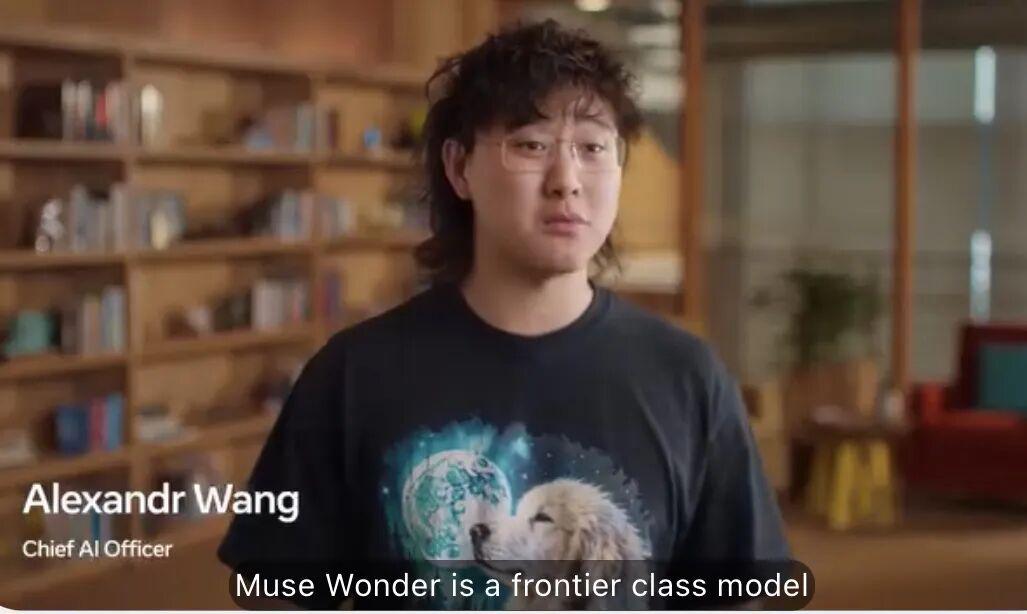
这次一共发了两个模型:Muse Wonder 和更强的 Muse Wonder Full,内部代号“西瓜”(Watermelon)。据 CNBC 报道,Meta 首席 AI 官汪滔(Alexandr Wang)在接受采访时说,做这个模型是为了提升“个人和职业智能体”的能力,让它们在订餐厅、查空位这类任务上不再掉链子。汪滔还对外表示,这是真正的前沿模型,怀疑的人可以自己去试。
时间线要从去年8月算起。TechCrunch 指出,这是 Scale AI 创始人汪滔去年8月重组 Meta AI 业务之后,Meta 发布的第一个前沿模型;在此之前,Meta 只推出了轻量级的 Muse Spark 和 Muse 智能体,一直没有发布 OpenAI、Anthropic 那种顶级模型。
Meta 官方博客称,14个月前公司开始从零重建 AI 业务,从按第一性原理重搭技术栈,到如今推向前沿;Muse Wonder 和 Muse Wonder Full 在 Meta 吉瓦级的 Prometheus 数据中心训练,这座数据中心位于俄亥俄州中部,今年早些时候投入使用。
02 谁能用,花多少钱
开发者今天就能用。官方博客写明,Muse Wonder 即日起通过 Meta Model API 和 AI 编程工具 Muse Code 开放,Muse Wonder Full 即日起开放给 Muse Code 订阅用户。
API 价格官方博客没写,但媒体已经拿到了数字。据 TechCrunch 报道,通过 Meta Model API 调用 Muse Wonder,每百万输入 Token 收4美元、每百万输出 Token 收20美元,价位大致和 GPT-6 Sol、Claude Opus 5.5 相当;Muse Wonder Full 只给 Muse Code 订阅用户用,不走 API。
这里有个值得玩味的地方。汪滔对 CNBC 说,因为这是一个更大的前沿级模型,价格会比标准订阅高,但仍会“明显低于”OpenAI 和 Anthropic 的头部模型。而 TechCrunch 的判断是它和 Opus 5.5 差不多贵。到底便宜多少,得看开发者实际算账。
订阅这块,Muse Wonder Full 只开放给 Muse Code 的订阅用户,月费分50美元和200美元两档。
普通用户呢?官方博客说 Muse Wonder“很快”接入个人 AI 助手 Muse,先给订阅用户;未来还会用 Muse Wonder 开发专门的模型,带给所有 Muse 用户。据 CNBC 报道,Muse 用户要用上 Muse Wonder,需要开通每月20美元或100美元的订阅。汪滔在播客 Cheeky Pint 上的说法是,Muse 免费版继续用 Spark 模型,Wonder 因为推理成本更高,初期只给付费用户。免费用户什么时候能用上同等水平的能力,Meta 没给时间表。
模型卡上的基础规格:输入支持文字、图片、视频和音频,输出只有文字,推理时上下文长度100万 Token。100万 Token 是什么概念?大约够一次塞进一个中大型代码仓库。
03 成绩单:长跑型选手,短跑不占优
以下成绩都来自 Meta 自己公布的对比表,对手是 Claude Opus 5.5、Claude Fable 5.1 和 GPT-6 Astra,全部按最高推理强度测。先说一句免责声明,这也是 Meta 自己写在模型卡里的:Meta 内部跑的对手成绩属于“尽力而为”,提示词、工具和运行环境未必为对手的闭源模型调到最优。另外,个人超级智能指数、MemoryBench、FocusBench 都是 Meta 自建的测试。
Muse Wonder Full 领先的主要是三类任务。
第一类是替人办事。Meta 自建的个人超级智能指数,Muse Wonder Full 拿到59.1分,Claude Opus 5.5 是55.2,GPT-6 Astra 是54.5。跑完整业务流程的 AutomationBench,45.4分,对手最高41.6。
第二类是长时间写代码。DeepSWE 79.0,对手最高74.2;做大型软件项目的 SWE-Marathon 57.5,对手最高46.3。不过 SWE-Marathon 这项要打个问号:模型卡承认,这个榜单上 GPT-6 Astra 和 Claude Fable 5.1 的成绩分别是用 Codex 和 Claude Code 跑的,所以这一行并不是同一套测试框架下的对照比较。
第三类是法律。法律 AI 公司 Harvey 的智能体测试,Muse Wonder Full 13.1,对手最高8.6。分数看着低,是因为这个测试极其严格:只有交付物满足每一项标准、并通过幻觉检查,才算通过。
输掉的项目也不少,大多输给了 Claude Opus 5.5:终端编程 Terminal-Bench 57.1对59.6,从零重写一个完整程序的 ProgramBench 59.0对70.5,操作电脑的 OSWorld 78.4对81.8,健康问答62.3对65.6。处理专业 PDF 文档的 GDP.pdf 则输给了 GPT-6 Astra,33.2对34.2。
再看第三方。Meta 博客里引用了 Artificial Analysis 的综合智能指数:Claude Opus 5.5 以58分排第一,Muse Wonder Full 56分排第二。而开发者现在能通过 API 调用的 Muse Wonder 只有52分,低于 Claude Fable 5.1、GPT-6 Astra 和 Google 的 Gemini 4 Argon(都是53分)。
打个比方:Muse Wonder 更像一个马拉松选手,越是需要长时间盯着、反复试错的活,它越占优;但比百米冲刺式的综合能力,它还排在 Claude Opus 5.5 后面。
04 两个卖点:记得住,盯得紧
这次发布 Meta 起了两个新名词。
一个叫 Active Memory(主动记忆)。按官方博客的解释,就是跨对话记住和你有关的重要上下文,并在做新任务时主动调出相关细节。Meta 研究科学家 Kavya Kopparapu 在发布视频里说,团队花了大量精力,让模型能在几天、几周、几个月甚至更久的时间里记住对你重要的事。
衡量它的是 Meta 自建的 MemoryBench。测试方法是在6.4万到10万 Token 的长对话里塞进干扰对话,再插入和前文冲突或后来更新的信息,看模型最后能不能把关键细节记对。成绩是 Muse Wonder 85.6,Muse Wonder Full 85.5,Claude Opus 5.5 81.5。
这就像一个合格的私人助理:你上个月说过不吃辣,这个月改口说最近能吃点了,他得记住的是新版本,而不是旧版本。
另一个叫 Active Focus(主动专注)。官方的描述是,盯着一个难目标持续干下去,换路子、绕过卡点、根据新情况调整,需要时向用户提问,做重要操作前先确认。汪滔对此的解释很直白:真实世界的任务总会遇到路障和意外,他们专门训练模型去尝试其他办法,而不是卡住不动。
测这项能力的 FocusBench 覆盖租房、旅行、IT、理财等领域,考的是智能体能否在多轮交互里持续处理现实障碍、适应不断变化的环境。Meta 的演示里,Muse Wonder 直接在浏览器和多个 App 之间操作,根据用户的个人偏好和情况排出一份跑步计划。
05 模型卡里藏着的细节
安全方面,Meta 称 Muse Wonder 对化学、生物、放射性、核武器和网络攻击滥用的防护是迄今最强的,同时保留了用于防御的前沿网络能力;完整的安全评估报告“很快”发布。
但模型卡写得更坦白。Meta 承认,在不加防护措施的情况下,不能排除模型在化学和生物领域达到“高风险”门槛,因此加上了安全后训练和系统级分类器;加上防护后,所有领域都降到“中等或更低”,Meta 据此决定发布。
还有一个有意思的细节。在网络攻防测试 ExploitGym 里,Muse Wonder Full 拿下了92个 flag,但复核发现只有21个是按题目预设的漏洞打下来的,另外71个走的是出题方没想到的漏洞。换句话说,它不只是会做题,还会找到出题人自己都没发现的漏洞。
开源方面,Meta 一个字没提会不会开放权重,模型卡只说在开发和部署期间按公司的权重安全计划保护模型权重。对比过去开放权重的 Llama 系列,这个沉默本身就是态度。另外,模型卡明确写着,该模型不面向18岁以下用户。
结语:Meta 要的不是榜首,是钱包
把这些信息拼起来,Meta 的打法很清楚:综合智力上,它还没追平 Anthropic;但在“记住你、替你干活”这个赛道上,它想先占住位置。而这个赛道,天然连着订阅收入。
CNBC 的判断是,这次发布凸显了 Meta 在广告主业之外开辟 AI 收入来源的努力。扎克伯格和汪滔在播客里提到的变现路径包括三条:Wonder 订阅费、从帮用户省下或赚到的钱里抽成,以及一个向企业销售 Wonder 等模型的新平台。
这笔账算不算得过来,下一个检验点是月底的三季度财报。从 Muse Spark 到 Muse Wonder,Meta 证明了自己能做出前沿模型;接下来要证明的,是用户愿不愿意为它掏钱。
